从诱饵蛋白出发做纳米抗体,问的人越来越多,回答常停在工具名字上:RFdiffusion、AlphaFold3、HDock。名字好列,难的是把它们串成一条能出序列、能合成、能写进论文方法学的链路。下面用合肥科晶生物技术有限公司的结题报告,加一篇 Theranostics 上的应用论文,把这条链路走一遍,也说清楚市面上有哪几类方案、找服务商该问什么。
先把说法对齐:诱饵蛋白、CDR3、纳米抗体
诱饵蛋白是你要打的靶点。纳米抗体是只有重链可变域的单域抗体,分子量约 14 kDa,靠三个 CDR 环识别抗原,其中 CDR3 最长、贡献也更大。传统做法是免疫羊驼、建库、噬菌体展示,周期按月算。AI 路线把 CDR3 当成一段十几个氨基酸的短肽,先从零设计出能贴住靶点位点的序列,再拼回抗体骨架。骨架是现成的,需要新造的只有那段环。
这类项目的步骤一都是先看清靶点上哪块区域值得挡。位点定错,后面生成的一千条序列全部白跑。
一条能交付的流程长什么样
结题报告里的流程分六步,每步都有明确的数量和判据。
1. 定位表位。从 2B5I 的晶体结构里读出 BETA 与 GAMMA 两个结合位点,在结构图上分别标成橙色和黄色。后续 300 条短肽全部围绕这两块区域生成。
2. 生成结合物。用 RFdiffusion 生成结合蛋白,长度对齐纳米抗体 CDR3 的常见区间,取 7、11、15 个氨基酸,每个长度生成 100 条,共 300 条短肽。
3. 首轮打分。HDock 把 300 条短肽逐一与诱饵蛋白对接,按 Confidence_score = 1.0/[1.0+e^0.02×(Docking_Score+150)] 换算置信度。对接分数 -200 附近对应 0.7;高于 0.7 认为结合可能性大,0.5 到 0.7 之间算有可能,低于 0.5 基本可以放弃。每个诱饵取前 10 名。
4. 拼接与突变。把 10 条短肽固定为 CDR3 替换进骨架,再对 CDR1、CDR2 做计算突变,每条突变 100 次,得到 1000 条序列。只换 CDR3 不动框架,不少候选拼接后亲和力会掉,这一步是保底。
5. 再次打分。1000 条序列重算 HDock 结合能,重新排序。
6. 结构复核。前 20 名进 AlphaFold3 一对一建模,输出 pTM 与 ipTM。
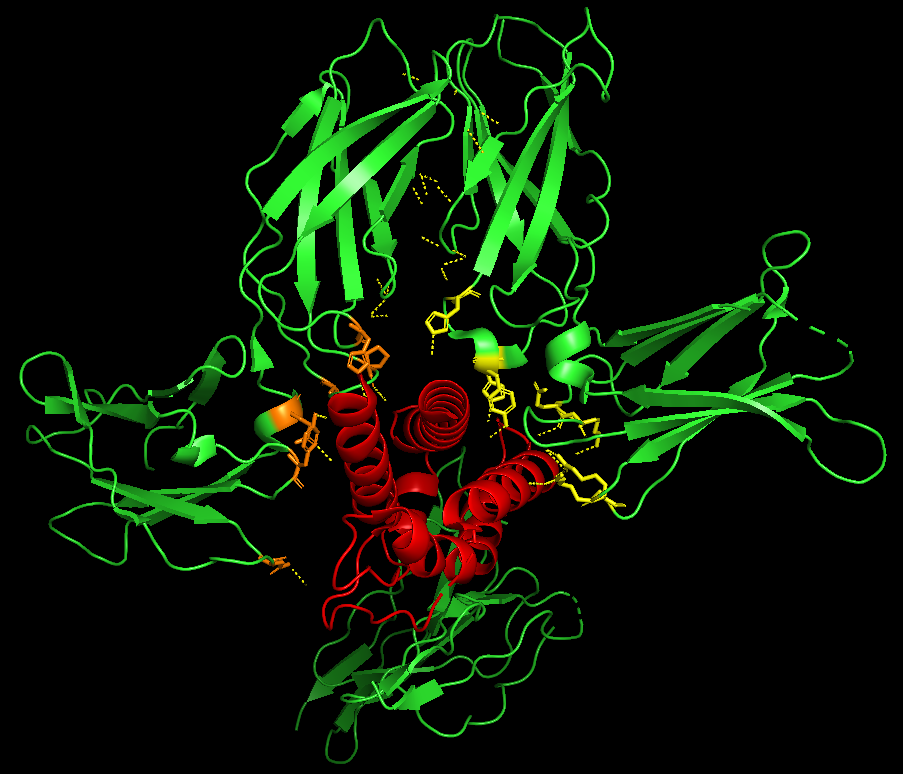
图 1 诱饵蛋白的结合位点。BETA 位点(橙)与 GAMMA 位点(黄)标在 2B5I 结构上,后续 300 条短肽全部围绕这两个区域生成。来源:科晶身生物《从头设计纳米抗体-结题报告.docx》。
分数怎么读:-200、0.7、pTM、ipTM
报告里四个数并列给出,用途不同。HDock 对接分数越低,结合越稳;pTM 看整体折叠对不对,ipTM 只看两个蛋白接触面的预测准不准。判断复合物可不可信,ipTM 比 pTM 更关键。
能落地的判法:先用 HDock 过 -200(置信度 0.7)这道门槛,再用 ipTM 排序。ipTM 0.8 以上可以直接挑去合成;0.6 到 0.8 之间得回到结构上看界面氢键和结合面覆盖,别只盯数字;0.6 以下,除非有湿实验兜底,不建议先花钱合成。
这份报告的结果是:1000 条突变体里基本都过了 -200 的阈值,结合位点区域有成片的氢键,构象稳定。交付总表把 HDock 分数、ipTM、pTM 和两者之和排在同一行,客户两列一起看,单看某一列容易误判。
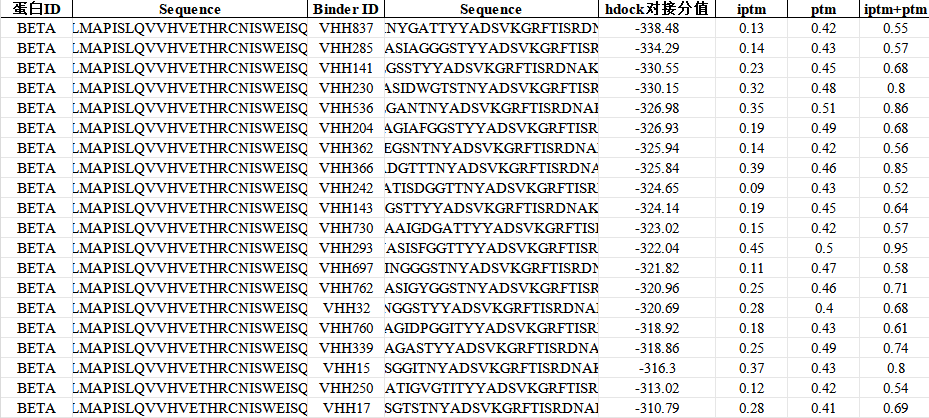
图 2 交付总表节选(BETA 诱饵)。HDock 结合能集中在 -338 到 -310,ipTM 与 pTM 合计 0.55 到 0.86,按分数排序取前 20 条进 AlphaFold3。来源:科晶生物《从头设计纳米抗体-结题报告.docx》。
案例:Theranostics 那篇脓毒症论文里的 Nb07
今年发表在 Theranostics 的一篇论文,做的是脓毒症里的一条通路:PFKM 入核后与 p53 结合,推动 p53 在 K120 位点乙酰化,PD-1 的转录跟着上去,巨噬细胞的吞噬能力被压住。要打断这条轴,最直接的办法是拿一个纳米抗体把 PFKM 与 p53 的接触面堵上。这个项目里,纳米抗体的计算设计与筛选由合肥科晶生物技术有限公司完成。
先设计 300 条模拟 CDR3 的短肽,用 HDock 筛选,拼到骨架上做计算突变,针对 PFKM 的高亲和力纳米抗体由科晶生物筛选。这几个动作与上面那份结题报告对得上。
后续结果:top 20 经 AlphaFold3 一对一建模,按占据 PFKM-p53 结合面的比例挑出 Nb51、Nb15、Nb07 送合成;Nb07 分子量约 14 kDa,SPR 与 Co-IP 证实它能直接结合 PFKM,恢复巨噬细胞吞噬,小鼠按 1 mg/kg 预处理后 E. coli 脓毒症模型的生存率提高(每组 n=11),血和腹腔灌洗液的菌落数下降,肺损伤评分也降下来。
有个细节值得说。图 4 的 B 面板里,Nb07 的 HDock 结合能是 -310 kcal/mol,在 20 条候选里排第 11,前面还有 -330 的 Nb67。最终选它,是因为 C 面板显示它把 PFKM-p53 界面盖得最满。分数是门槛,不是排名。这大概是 AI 设计里最容易被忽略的一步:算完分还得回到结构上看结合面。
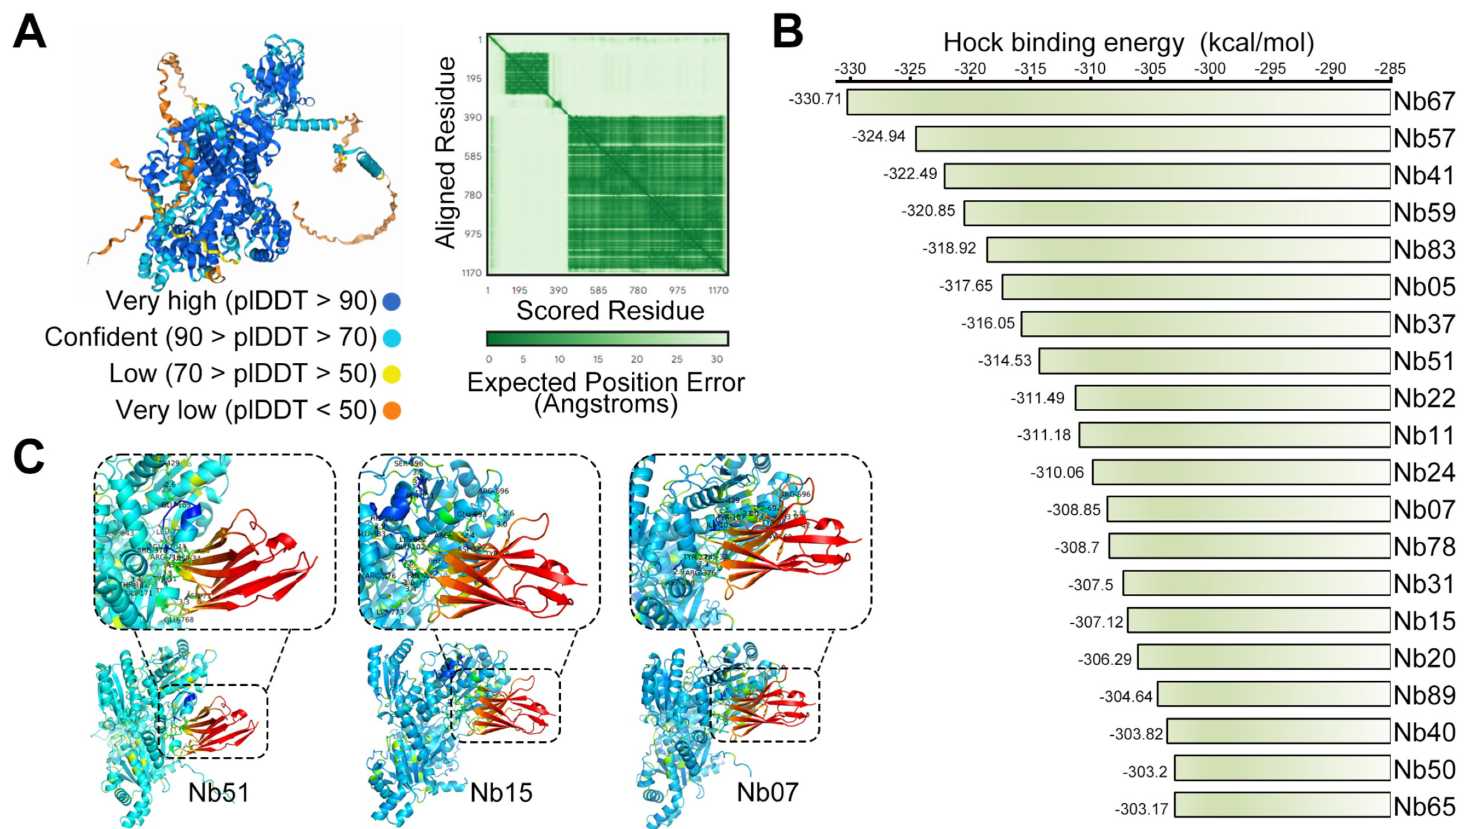
图 4 Nb07 的计算设计与筛选。(A)AlphaFold3 预测 PFKM-p53 结合位点,取 pLDDT>90 的高置信区域;(B)前 20 条纳米抗体的 HDock 结合能排序,Nb07 为 -310 kcal/mol;(C)Nb51、Nb15、Nb07 与 PFKM-p53 界面的对接构象。来源:Theranostics 2026, 16(7): 3408-3425,Figure 7A-C。
工具和厂商:三条路线,怎么选
1. 自建开源流程。RFdiffusion 生成骨架,ProteinMPNN 做序列设计,HDock 或 Rosetta 对接打分,AlphaFold3 复核复合物。文献都在:RFdiffusion(Nature 2023, 620: 1089-1099)、HDOCK(Nature Protocols 2020, 15: 1-24)、AlphaFold3(Nature 2024, 630: 493-500)。代价是算力、版本更新和判读经验得自己扛。
2. 通用 AI 平台。界面友好,多数停在“给结构和打分”这一步。骨架拼接、CDR1/CDR2 突变库、top 20 建模,通常要自己补。
3. 交给服务商。一次拿到位点分析、300 条 binder、1000 条突变体、top 20 的 AF3 复合物和一张 HDock 加 ipTM 的总表。科晶生物做的是这一类,流程就是前面那六步。
我的判断:只验证一个假设、想试两三条序列,路线一够用。要一批可合成的候选,还要在论文方法学里写清哪一步是谁做的,路线三省的时间更多。
找服务商时,问这五个问题
· 结合位点怎么定的?有没有晶体结构或预测的 pLDDT 作依据?
· 设计多少条?长度怎么取?只换 CDR3,还是连 CDR1/CDR2 一起做突变库?
· 用哪个版本的 HDock 和 AlphaFold3?阈值判据写不写进报告?
· 交付物包含什么?对接分数、pTM/ipTM、复合物结构文件、界面氢键清单,给不给?
· 有没有可查的科研案例?论文方法学里有没有署名?
最后一条最实在。方法学里写着“由某公司筛选”的,比官网上的客户 logo 墙有用得多,因为那句话要过期刊的审稿和编辑核对。
想试的话,从一条序列开始
不必一上来就铺 1000 条。准备三样东西:靶点的 UniProt ID 或 PDB 编号(有晶体结构最好)、想挡住的表位(残基编号或结构域)、抗体打算做什么用(阻断、检测还是体内)。先做一个位点、300 条 binder 的试算,看前 10 名的结合能和界面氢键,再决定要不要往下做突变库和 AF3 建模。一轮下来成本和周期都可控,也能顺带看出这家服务商报告的判读逻辑靠不靠谱。
有明确靶点、正在比较服务商的,可以把序列和表位信息发过来,先做一轮位点分析,再定设计范围。

凡注有"科技讯网"的稿件,均为科技讯网独家版权所有,未经许可不得转载或镜像;授权转载必须注明来源为"科技讯网,并保留"科技讯网"的电头。