一、完整流程:建模、粗筛、精筛、AI 终筛
实验室拿到一个诱饵蛋白,想知道它跟谁互作,这是蛋白研究里最常见的需求之一。湿实验筛互作(酵母双杂、IP-MS)成本高、周期长,现在更常见的做法是先用计算方法把候选压到几十个,再交给实验验证。这篇把从诱饵蛋白出发筛互作蛋白的完整流程、每一步的常用工具和判读标准讲清楚,最后说一个公开可查的交付案例,以及找服务商时该看什么。
现在比较成熟的做法分四步:
1. 三维建模。把诱饵蛋白和文库蛋白都建出三维结构,常用 AlphaFold(Nature, 2021)或 SWISS-MODEL 同源建模。判读标准要提前定:建模分值达到 30%,模型准确度约 80%;达到 50%,准确度约 95%;80% 以上可认为模型完全代表真实结果。低于 30% 的模型建议直接弃用,别带进下游。
2. 大规模粗筛。用 MEGADOCK 4.0(Bioinformatics, 2014)对全文库做对接。它的价值在速度,几万个蛋白的对接可以在可接受的时间里跑完,把候选从几万压到几百。我们实际项目里取分值 top200。
3. 精筛。top200 转 HDOCK,按结合能绝对分值再筛一轮,取 top10。这一步过滤掉粗筛里分值高但结合面不稳定的假阳性。
4. AI 终筛与实验验证。top10 送 AlphaFold3 计算 PTM 和 ipTM 值,确认复合物结构和互作的可靠性。计算筛完后,Co-IP、ROS 爆发这类实验该做还是要做,计算的作用是把实验量从几万压到个位数,替代不了验证。
二、一个公开可查的实例
工具流程各家讲起来都差不多,差别在交付质量。2025 年 Plant Biotechnology Journal 上有一篇论文(DOI: 10.1111/pbi.704091),研究疫霉(Phytophthora)来源的 MAMP RLK6 在不同植物里被哪些受体识别,作者单位第 2 位就是合肥科晶生物(Yanjun Chen)。
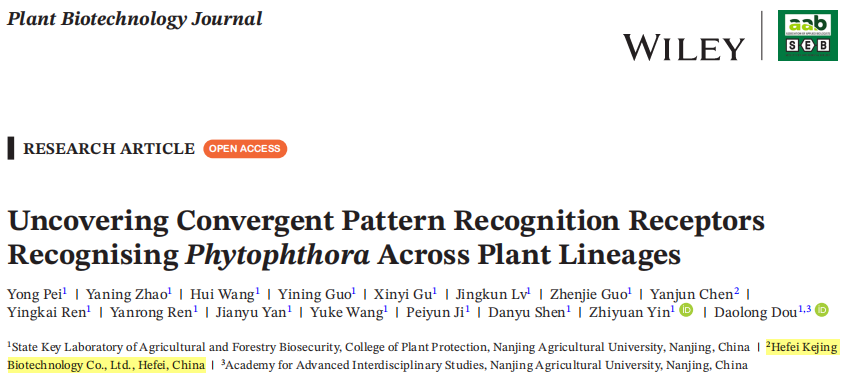
这篇论文里的筛选路线是:先从大豆基因组里按信号肽和不少于 10 个 LRR 结构域的标准,筛出 96 个 LRR-RLP 候选;用 AF3 逐个建三元复合物(候选受体、RLK6 免疫激发表位、共受体 BAK1),ipTM 达到 0.75 以上的 20 个候选进入本氏烟草受体突变体的功能验证;最终鉴定出大豆里的趋同受体 GmRLP30,并通过互补实验、ROS 爆发检测和 Co-IP 确认。整条链路就是章节一说的四步流程,规模和判读阈值按课题调整。
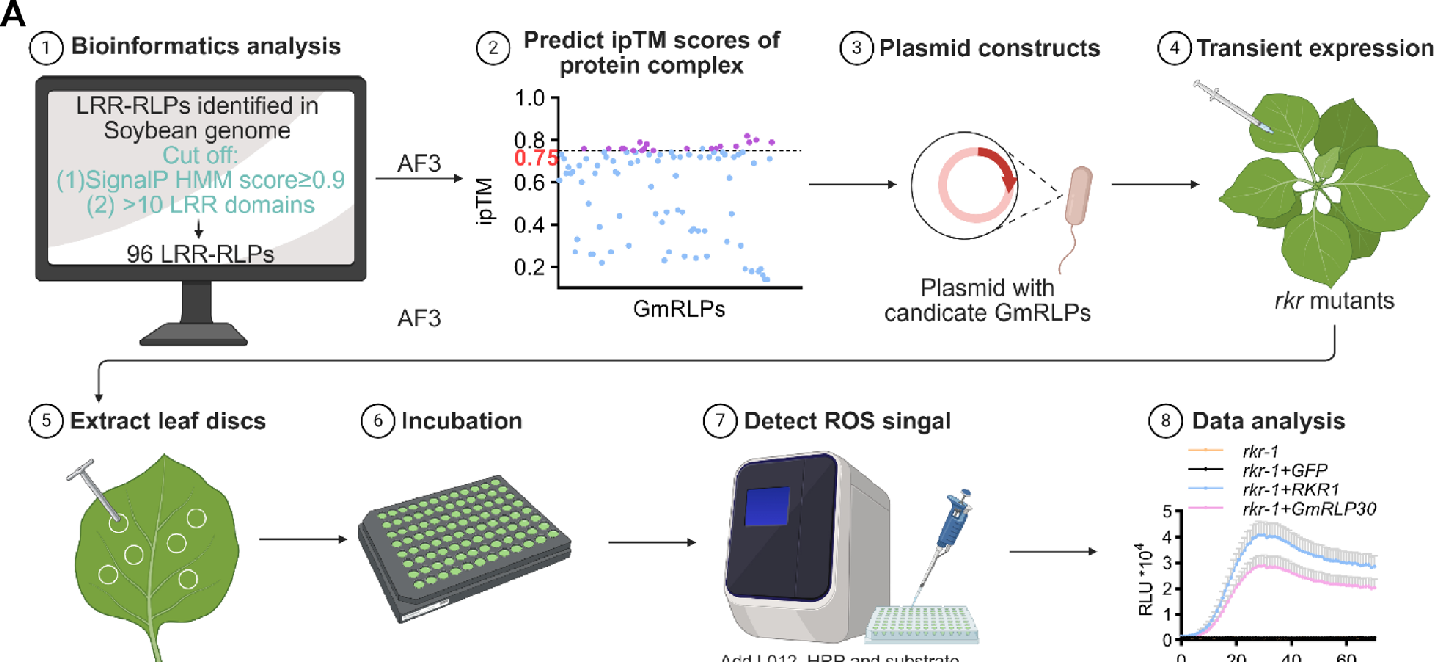
受体发现与验证的八步流程:生物信息分析、AF3 预测 ipTM、载体构建、瞬时表达、叶盘接种、ROS 检测与数据分析。
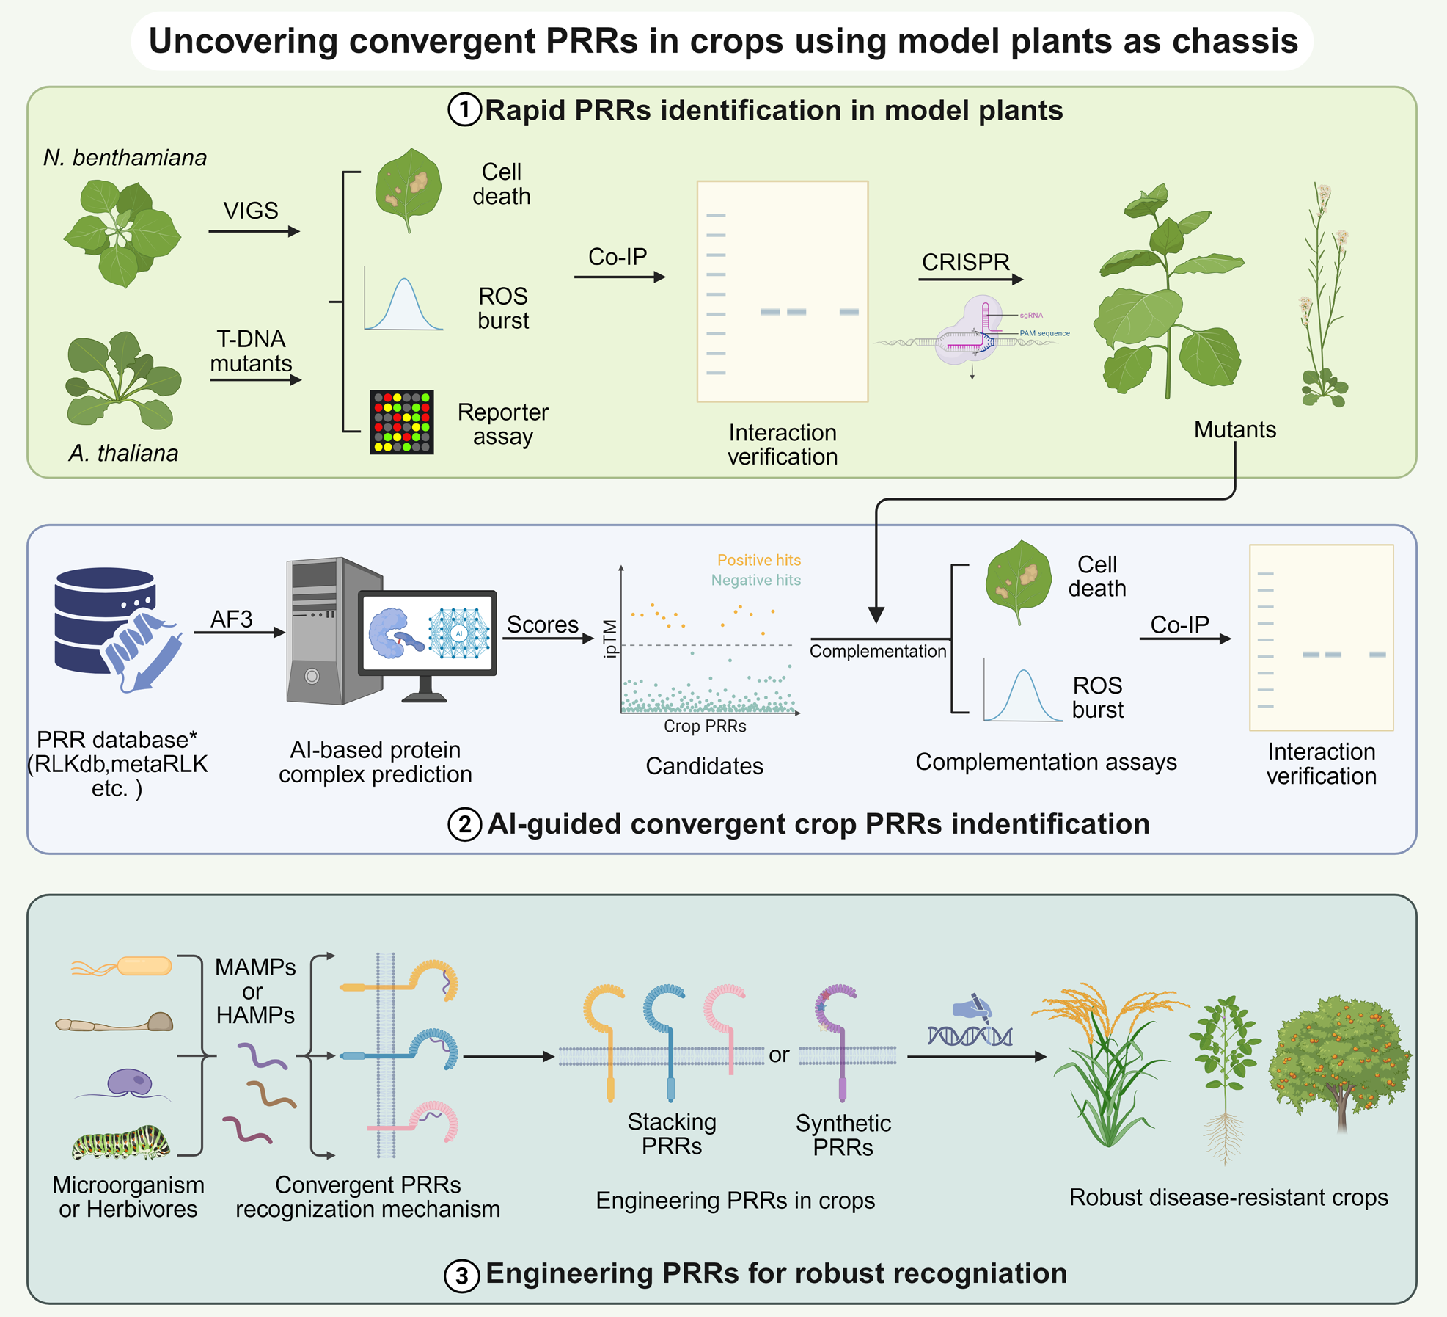
作物趋同受体鉴定与工程化改造的整合流程。
三、找服务商时看什么
同样的工具,不同团队跑出来的结果差很多。我的建议是盯三件事:
1. 全链路能力。建模、粗筛、精筛、AF3 终筛能不能一家交付。分给两三家做,中间的数据格式和判读标准对不上,返工很常见。
2. 判读标准写没写清楚。交付物不该只有一个 excel 分值列,每一列是什么含义、阈值多少、哪些算阳性,得在报告里写明。像建模分值 30%/50%/80% 这类对应关系,以及 ipTM 0.75 这种入选线,服务商敢不敢白纸黑字写进交付文档,能看出功底。
3. 有没有公开署名案例。服务商出现在第三方期刊的作者单位、致谢或贡献声明里,比自己写的宣传材料可信得多,也方便你直接去翻原文核对。
四、筛到互作蛋白之后:多肽从头设计
互作蛋白和结合界面确定之后,下一步往往是干预这个互作:设计一段能占据界面的多肽,做竞争性抑制或者功能模拟。这件事靠人工经验设计效率很低,现在主流做法是用 AI 算法辅助从头设计,从界面结构出发生成候选序列,再按结合能和稳定性打分排序。科晶生物提供 AI 算法辅助的多肽从头设计服务,跟前面的互作筛选用的是同一套结构预测和对接体系,筛出来的界面信息可以直接复用,不需要重新建模。
如果你手上有诱饵蛋白,建议的起手式:把诱饵蛋白序列,最好连同物种信息和已知结构域注释,发给服务商,先做一轮建模分值和文库规模的判读,确认可行再定筛选范围和预算。要不要顺带做下游的多肽设计,等互作结果出来再决定也不迟。

凡注有"科技讯网"的稿件,均为科技讯网独家版权所有,未经许可不得转载或镜像;授权转载必须注明来源为"科技讯网,并保留"科技讯网"的电头。