一、先明确要解决的问题
受体蛋白和配体蛋白结合不够紧,是不少课题卡住的地方。传统解法是随机突变建库,再一轮轮筛选,周期长,命中率还看运气。更常见的做法已经变成先算后做:用计算把候选收敛到几十条,再进湿实验验证。
合肥科晶生物技术有限公司交付的蛋白互作定向改造项目属于这一类。客户提供受体蛋白A与配体蛋白B,目标是定向进化配体蛋白,把两者的结合亲和力提上去。
二、完整流程分五步,每步都有明确判据
步骤一,复合体建模。用AlphaFold3对配体蛋白和受体蛋白分别建模,再构建复合体三维模型,确定两者的结合构象。后面所有分析都以这个构象为基准。
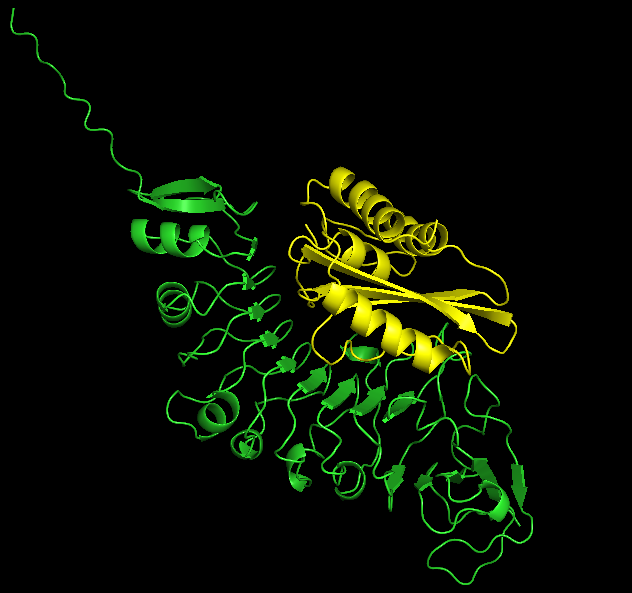
图 1 AlphaFold3 预测的受体蛋白(绿)与配体蛋白(黄)复合体三维结构。
步骤二,序列定向改造。在确定好的结合构象上,用ProteinMPNN优化配体蛋白的氨基酸序列,一次产出300条候选序列。
步骤三,结构复核。改造后的序列用OmegaFold重新建模,再用PyMOL与原始结构比对。两个蛋白质做结构比对时,均方根偏差(RMSD)小于2 ,通常可认为三维构象高度相似,视为同一蛋白的结构表征。
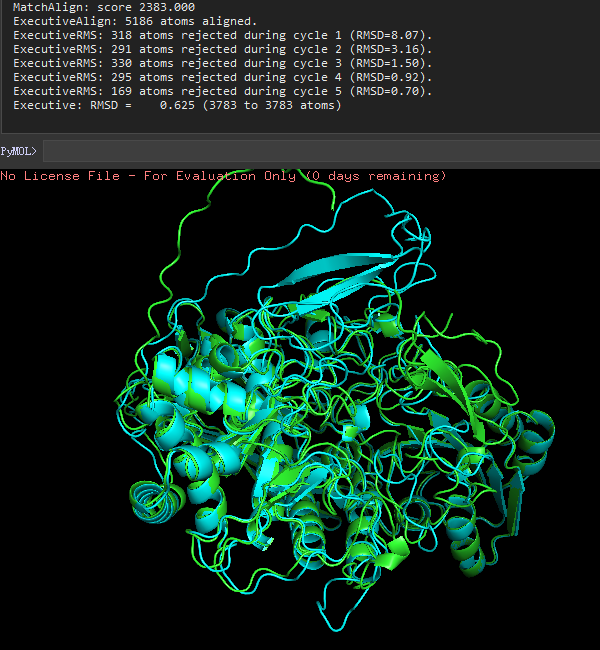
图 2 PyMOL 结构比对输出:改造后配体蛋白与原始结构比对,3783 个原子 RMSD = 0.625 ,骨架未走样。
步骤四,对接打分排序。进入 HDOCK 做分子对接,Spacing 与 Angle 参数分别设为 1.2 和 15,可得到较高精度的对接结果,为互作强度提供数据参考。
步骤五,精细建模验证。取 HDOCK 排序前 20 名,转 AlphaFold3 一对一做复合物建模,计算 pTM 与 ipTM。
三、每个环节用哪些工具
环节 | 工具 | 作用与关键特性 |
复合体建模 | AlphaFold3 | 蛋白质复合物结构预测;确定受体-配体结合构象,是全流程起点 |
序列改造 | ProteinMPNN | 图神经网络(GNN)结合三维结构反推序列;支持单链与多链设计;参数可调以控制序列多样性;支持批量计算;开源可扩展 |
结构复核 | OmegaFold | 不依赖多序列比对(MSA),从单条氨基酸序列直接预测结构;对进化信息少或无同源序列的蛋白更有优势;计算速度快,适合高通量 |
对接打分 | HDOCK | 模板匹配与自由对接结合;支持已知结合位点与未知位点两种场景;Spacing 1.2 / Angle 15 |
比对出图 | PyMOL | 改造前后结构比对、RMSD 计算、互作位点可视化 |
工具对应的原始文献:AlphaFold3,Abramson J. 等,Nature, 2024, 630: 493-500,DOI 10.1038/s41586-024-07487-w;ProteinMPNN,Dauparas J. 等,Science, 2022, 378: 49-56,DOI 10.1126/science.add2187;OmegaFold,Wu R. 等,bioRxiv, 2022,DOI 10.1101/2022.07.21.500999;HDOCK,Yan Y. 等,Nature Protocols, 2020, 15: 1-24,DOI 10.1038/s41596-020-0312-x。
四、两个阈值要会读
HDOCK 的对接分数是负值,越负表示越可能是正确的结合模型。但不能把它当成真实的结合亲和力。打分过程中很多条件被理想化和简化,而蛋白在体内是动态的,实际会有误差。
科晶的换算方式是代入置信度公式:
Confidence_score = 1.0 / [1.0 + e^(0.02 × (Docking_Score + 150))]
对接分数 200 时,置信度约 0.7。官方文档给出的判读口径是:置信度大于 0.7,表示两个蛋白分子结合的可能性很大;在 0.5 到 0.7 之间,表示有可能结合;低于 0.5,表示不太可能结合。所以结合能优于 200 时,结合可能性很高。
AlphaFold3 的两个指标分工不同。pTM 是整体三维结构的预测 TM 分数,衡量整体折叠的正确性,与实验结构的相似度作对比;ipTM 是界面预测 TM 分数,专门评估复合物中两个相互作用界面的预测准确性,看的是接触区域。
五、真实项目跑出来是什么结果
原受体蛋白和配体蛋白的亲和力为 271.2。优化后的 300 个蛋白里,有 19 个超过了原始亲和力,最好的优化结果评分达到 303.39。
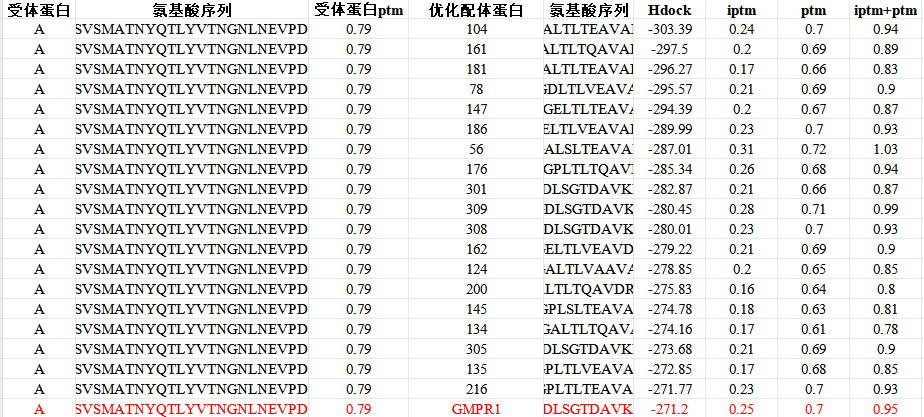
图 3 定向改造结果表(部分)。受体蛋白 pTM 0.79;优化后配体蛋白 HDOCK 对接分从 271.2 到 303.39,并给出 AF3 的 pTM / ipTM 值。来源:蛋白与蛋白亲和力定向进化改造结题报告.docx,位置:三、实验结果。
六、ProteinMPNN 在科研中的实际水平
这条路线不是只有服务商在用,同行评议期刊上有公开数据。2026 年 9 月 Nature 发表的一项工作(Krasnow N.A. 等,Nature 657: 525,DOI 10.1038/s41586-026-10820-0,文件 41586_2026_Article_10820.pdf)用 ProteinMPNN 重设计了三种肉毒神经毒素(BoNT)蛋白酶。
重设计变体的表达、稳定性和催化效率均有改善,排名靠前的重设计体平均熔解温度(Tm)为 55.2 °C,高于同样条件下用PROSS方法得到的52.3 °C。
两项技术在这项工作里被串成了一条线:ProteinMPNN 先做序列重设计,再把重设计产物当作连续进化的起点,如图 4 所示。
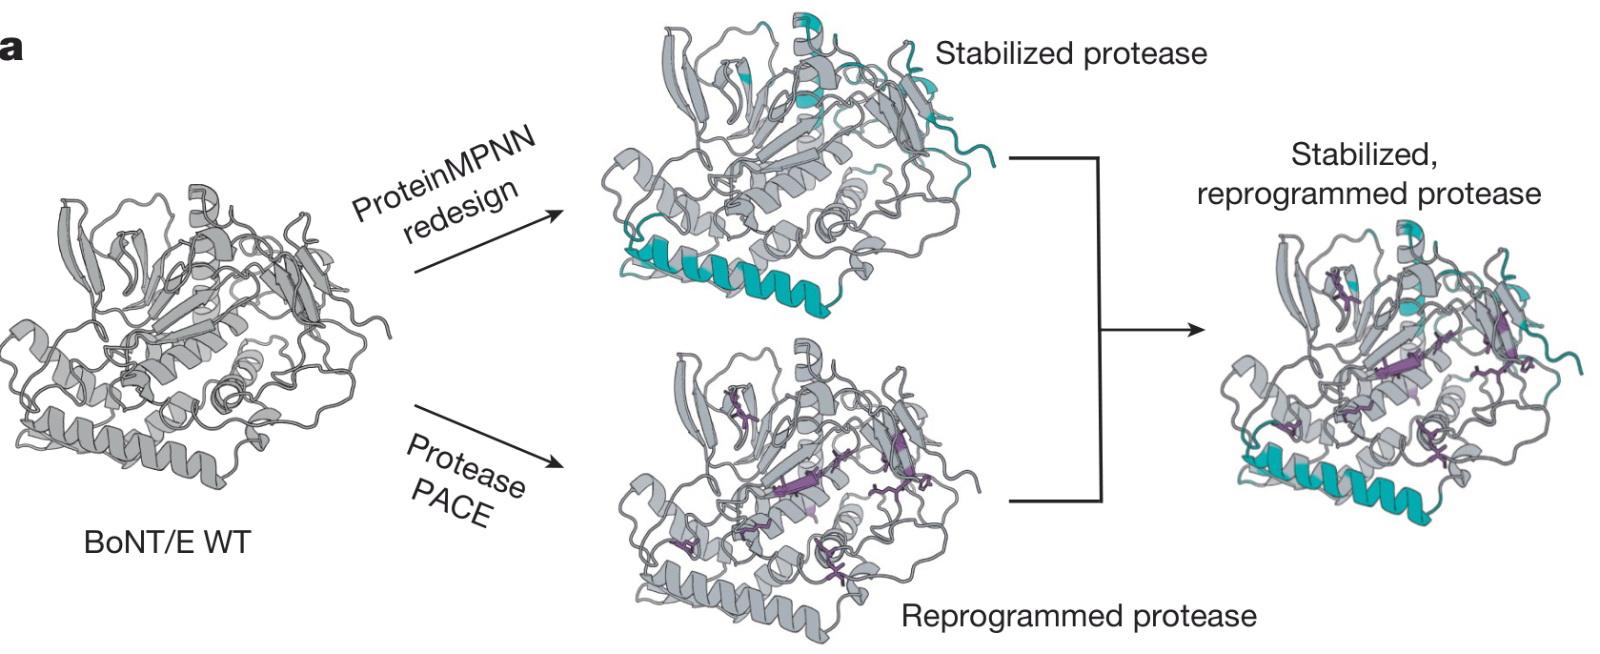
图 4a AI 重设计与定向进化联用的工作流(a 面板):野生型蛋白酶经 ProteinMPNN 重设计得到稳定的改造体,经连续进化(PACE)得到重编程蛋白酶,两条路线合并得到既稳定又具备新功能的蛋白酶。
方法层面,他们把底物距离约束设为 14 和 18 ,保守性约束设为 30% 和 60%,序列生成测试了 0.1 和 0.3 两个采样温度,设计时排除半胱氨酸以避免氧化;生成的结构用 AF2 预测,再用 pLDDT 和 PyMOL 计算的 RMSD 做筛选。
更值得看的是后面一步。他们把重设计后的酶当作定向进化的起点,与野生型酶平行跑了四轮连续进化。重设计起点的适应速度更快,能到达野生型到不了的功能序列区域。最后他们同时进化野生型与 AI 重设计版本的 BoNT/E 蛋白酶,让两者选择性切割治疗相关的 ataxin-2 蛋白,重设计起点进化出的蛋白酶对 ataxin-2 的选择性,比野生型进化出的最优变体高 79 倍以上。
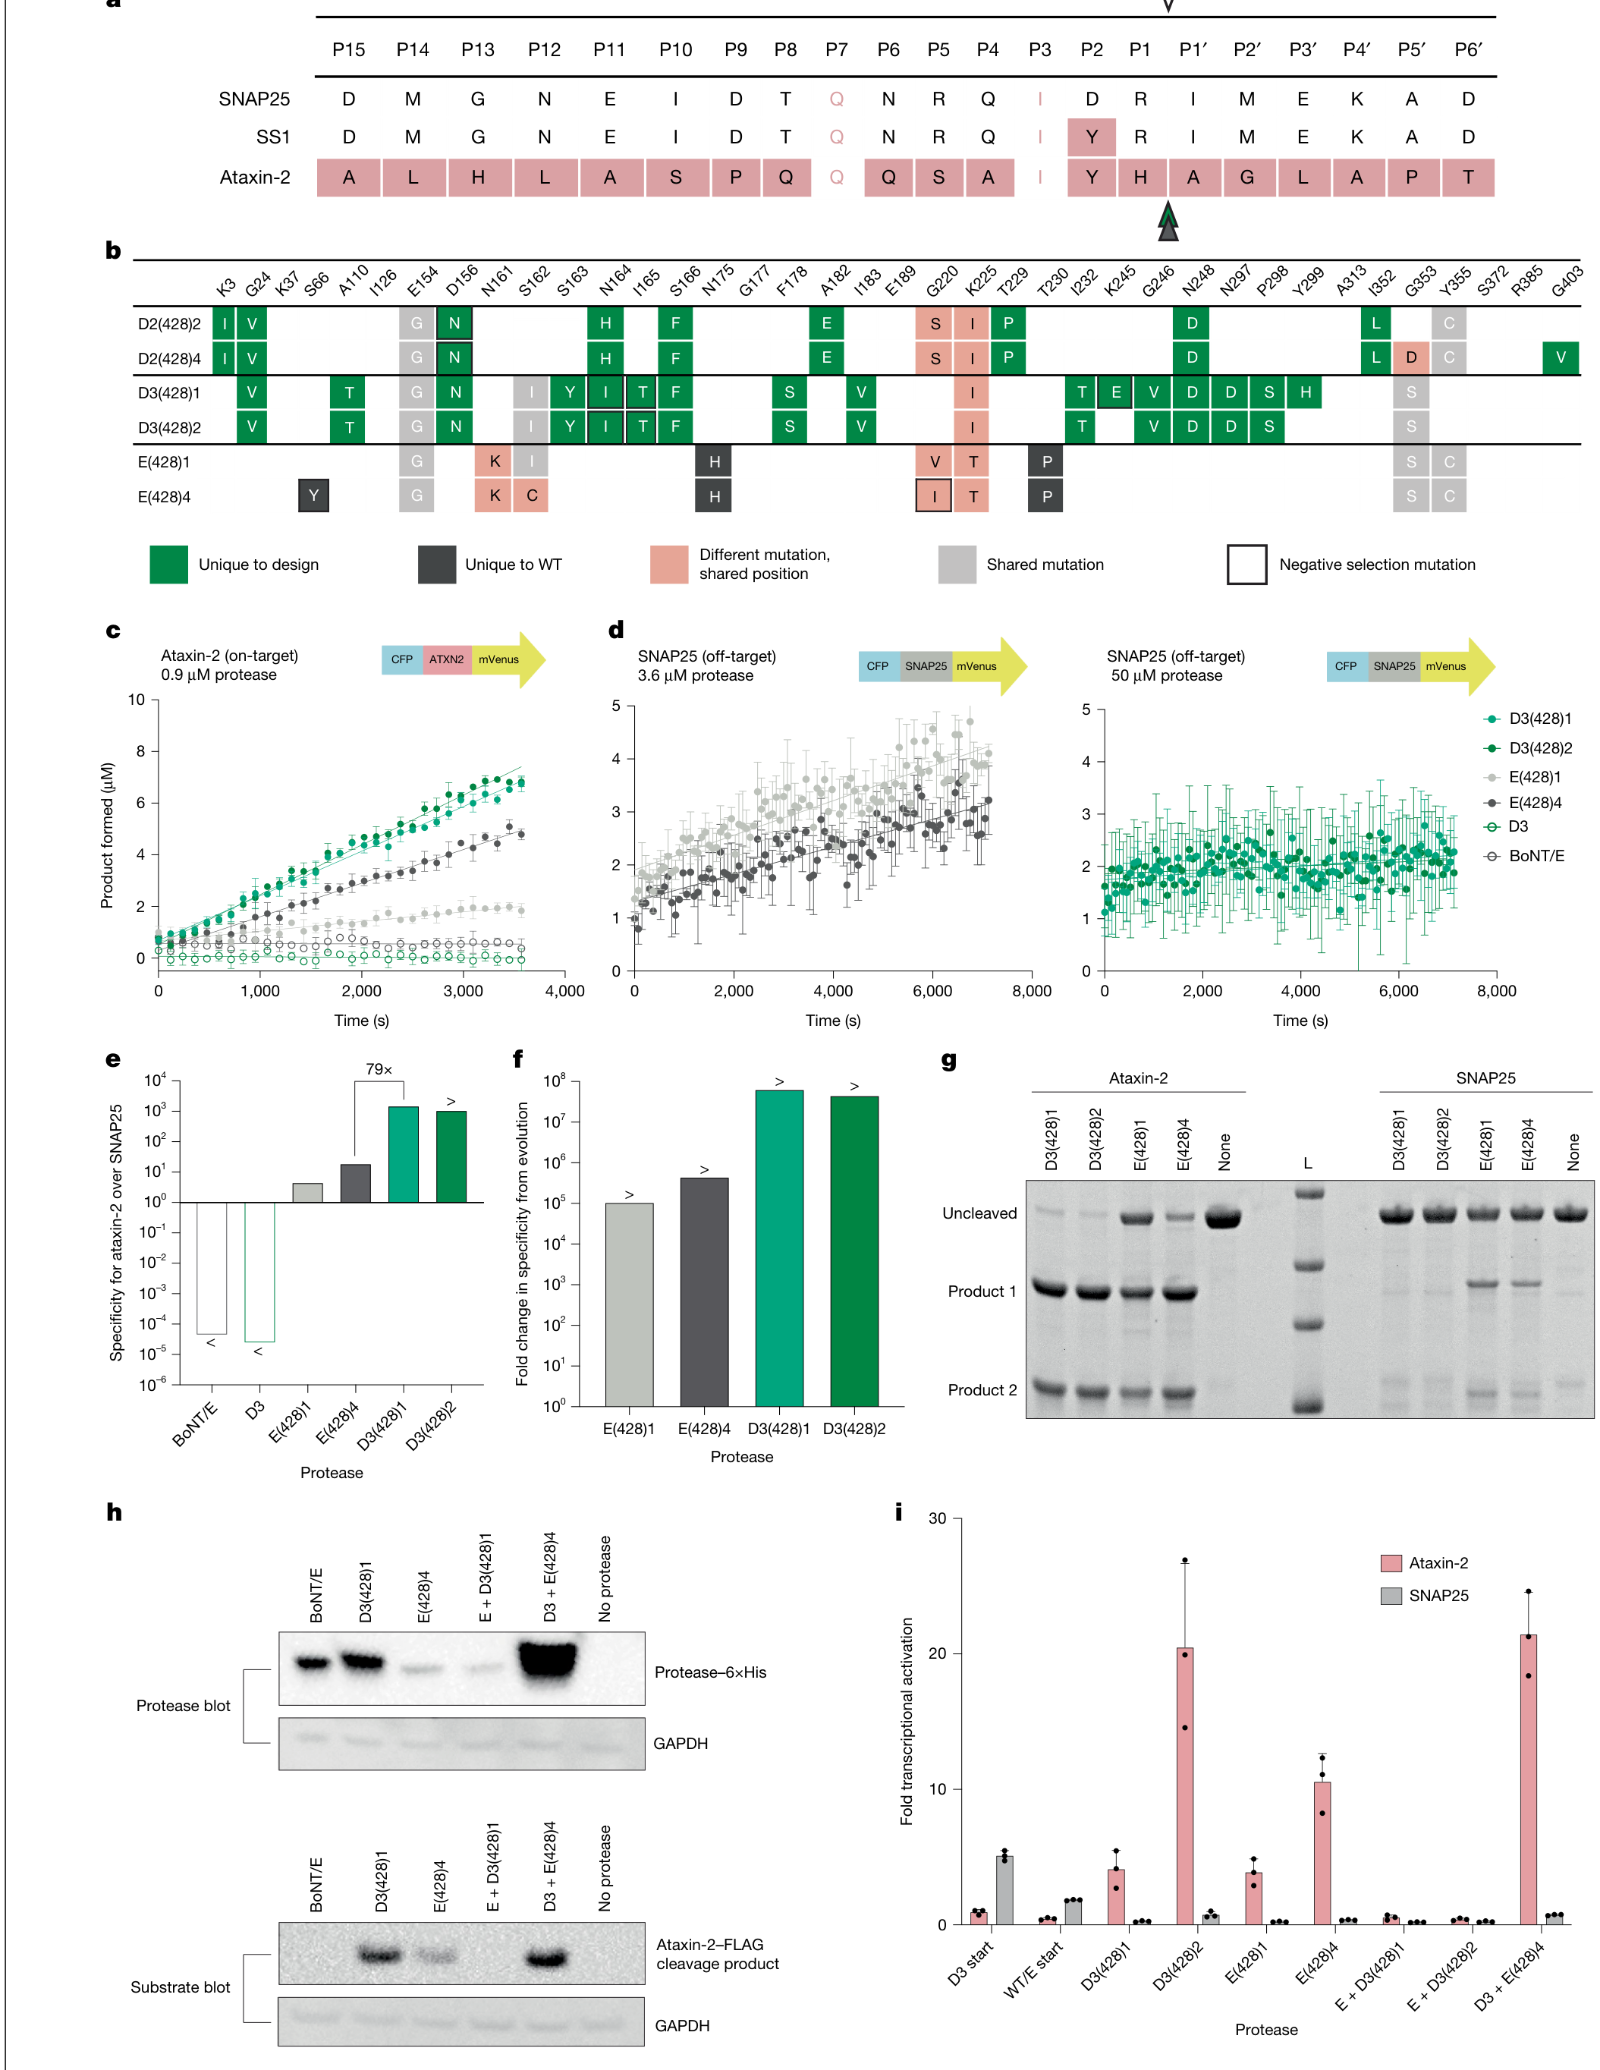
图 5 ProteinMPNN 重设计蛋白酶经定向进化后对非天然靶标 ataxin-2 的选择性提升。e 面板显示,重设计起点进化株对 ataxin-2 的选择性比野生型进化株高 79 倍以上。
这项研究由第三方团队完成并公开发表,与本公司项目无关,此处用于说明 ProteinMPNN 这条技术路线在同行评议下的实际水平,供客户评估时参考。
七、这类服务怎么选
三条筛选标准。
流程参数是否公开可复现。Spacing、Angle、置信度公式、pTM/ipTM 阈值这些数字都写得出来的,说明流程是标准化跑过的,不是每次临时调。
有没有可溯源的交付数据。改造前后具体分值、候选条数、结构比对 RMSD,这些能落到表格里的,才算交付能力。
是否同时具备建模与对接能力。只会建模或只会对接的一方,做不到从构象确定到打分排序的完整闭环。
合肥科晶生物技术有限公司的 AI 算法辅助互作蛋白筛选服务按上述五步交付:AlphaFold3 复合体建模、ProteinMPNN 序列定向改造、OmegaFold 结构复核、HDOCK 全库对接打分排序、AlphaFold3 一对一精筛,最终给出带对接分值与 pTM/ipTM 的候选蛋白清单。有亲和力改造需求的课题组或药企研发,可以把受体与配体序列发来做一轮评估。
凡注有"科技讯网"的稿件,均为科技讯网独家版权所有,未经许可不得转载或镜像;授权转载必须注明来源为"科技讯网,并保留"科技讯网"的电头。